thảo luận Hội Dev 35 đi phỏng vấn tìm việc.

  • Người tạo chủ đề Người tạo chủ đề Kaiser2013
  • Ngày bắt đầu Ngày bắt đầu
bác có nghĩ tương lai có kiểu kiến trúc nào db phân tán phần db, app phân tán phần app , miễn sao lúc read , write nó tìm đc đúng không
nó là mấy cái NoSQL đó thôi , đọc thì đang hiểu là fen muốn cho sql thì đọc thử CockroachDB, TiDB, 2 cái này chưa dùng mấy nên nhờ các fen khác vào review
 
db lưu trên ổ cứng bác, message queue lưu trên ram để nâng cao tốc độ , có thể nó backup vào ổ cứng nhưng để khôi phục lại nếu gặp sự cố, lúc đó lại làm 1 cụm auto scale message queue nữa khá thốn

bác có nghĩ tương lai có kiểu kiến trúc nào db phân tán phần db, app phân tán phần app , miễn sao lúc read , write nó tìm đc đúng không

em nghĩ là có nhưng sẽ là đám gg, amz nó làm và bán dịch vụ cho mình sài, thốn tiền phết
có hết rồi, có tiền ko
 
phình về cấu trúc là sao :oops:
Có case study của notion đây. tưởng shard dễ lắm ah.

ý là thêm schema , table , cột , khóa ... ấy thím , kiểu mình ngồi phía trên , tạo bảng , tạo schema , bọn bên dưới tự tính toán để shard , tự thực thi mấy cái kỹ thuật để phân tán , em nghĩ nếu đc vậy thì ngon , hiện giờ vẫn phải tự làm dựa trên tình hình của ứng dụng và nghiệp vụ của ứng dụng
 
mấy bác chém gió về kĩ thuật đi , cứ chém đâu đâu ko

cho em hỏi, giả sử ở tầng app , mấy bác sài load balance, rồi mấy con server viết bằng rust chịu tải khủng khiếp , thì có cần chia db per services không

vì em thấy tầm nào quả DB cũng là cái nút thắt , nếu db chứa dữ liệu nosql thì thôi không nói

chứ DB chứa dữ liệu quan hệ , mà chia DB ra trên nhiều services , tới lúc cần query dữ liệu liên quan trên nhiều services, hoặc write dữ liệu lên nhiều services là mệt

chưa kể gọi services chồng chéo nhau , ừ thì các bác sẽ dùng các message queue , với pub/sub pattern để tránh gọi chằng chịt , nhưng nó cũng có rủi ro nếu server message queue sập

nên cho em hỏi, hiện giờ có con db nào thiết kể mà đạt được
1. tự động phân tán
2. nếu db phình to về mặt cấu trúc, nó cũng tự shard

-> nói chung dev sẽ chỉ lo việc tạo cấu trúc db , ràng buộc, query các thứ, còn chuyện phân tán thế nào khi dữ liệu phình to, cấu trúc phình to, hệ quản trị sẽ có chỗ config để handle

-> mục đích là để ko phải cắt nhỏ quá từng DB cho từng services , những domain nào 100% ko có gì phục thuộc vào bọn còn lại thì mới tách DB ra cho từng services
Thì thực tế có ai bắt dev lo mấy phần này đâu bạn, hay dự án nhỏ quá không có cloud engineer, devops, infra team, nếu vậy thì đâu cần tính workload cho nó cao siêu làm gì.
Còn mấy cái bạn nói thì cloud nó lo hết rồi, db replicate, read write riêng hết từ đời nào rồi. Còn chỗ chia db theo service thì quá mơ hồ, sao bạn ko tính đúng con loadbalancer tạch đi cho nhanh
 
Anh ráng ra trung tâm tiếng Anh học giao tiếp với giáo viên bản xứ như Anh, Úc, Mỹ để lên trình nghe nói nếu tiếng Anh hiện tại chưa tốt. Tiền học phí 1 năm dưới 20 củ thôi
Rồi học design system dùng Redis, Kafka hay RabbitMQ đi thì mới có hy vọng xin được việc khá hơn nếu có bị layoff. Thuê 1 con VPS 50$ 1 tháng mà tập tành làm pet project Rust ActixWeb luôn cho máu, có AI hỗ trợ giờ làm dễ ợt
side project mà thuê hẳn VPS $50/m có lãng phí quá không :ops:

Tôi cũng làm cái web app mà còn đang lăn tăn con vps ~$8/m liệu có thừa thãi quá không đây. Lúc đầu cũng xác định làm gì có users đâu mà.
 
Anh ráng ra trung tâm tiếng Anh học giao tiếp với giáo viên bản xứ như Anh, Úc, Mỹ để lên trình nghe nói nếu tiếng Anh hiện tại chưa tốt. Tiền học phí 1 năm dưới 20 củ thôi
Rồi học design system dùng Redis, Kafka hay RabbitMQ đi thì mới có hy vọng xin được việc khá hơn nếu có bị layoff. Thuê 1 con VPS 50$ 1 tháng mà tập tành làm pet project Rust ActixWeb luôn cho máu, có AI hỗ trợ giờ làm dễ ợt
FE với mobile thì học thêm gì bạn.
 
Ông thisismyfirstclone chém tào lao vl. Đang nói về app + db tự nhiên đánh sang low level OS write buffer. Phần write buffer thì db nó handle, có ai mà đi viết lại cái db bao giờ. Mà bọn db nó cũng phải đảm bảo durability thì write buffer cũng là trong lúc cái câu query / transaction thôi chứ khi commit phải persist xuống đĩa luôn chứ buffer gì nữa.

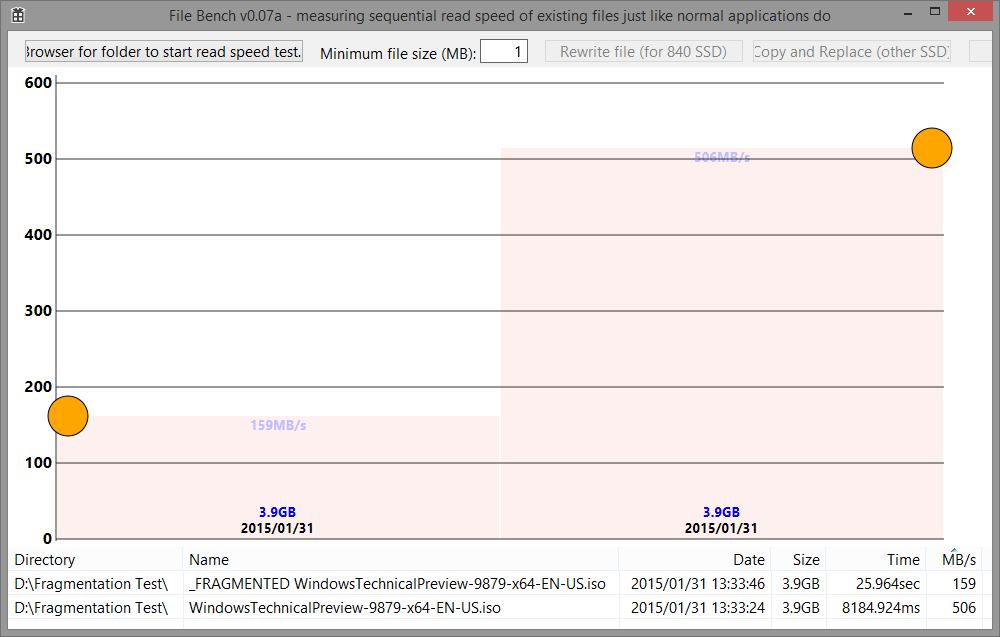
Fragmentation cũng không liên quan tới write buffer, nó là do implementation về block allocation của file system. SSD không cần defragmentation vì không có disk seek như HDD. Truy xuất block đầu hay block cuối của SSD đều tốn thời gian như nhau cả
DB lúc perform writes cũng không write thẳng vào đĩa mà buffer vào memory trước rồi lúc sau mới ghi vào đĩa. Thế nên DB mới có khái niệm Write-Ahead Log (dùng để revert khi có sự cố). Ví dụ của mysql là redo log.
MySQL :: MySQL 8.4 Reference Manual :: 17.6.5 Redo Log (https://dev.mysql.com/doc/refman/8.4/en/innodb-redo-log.html)
Việc hiểu buffer writes là để đọc hiểu db on-disk structures
MySQL :: MySQL 8.4 Reference Manual :: 17.6 InnoDB On-Disk Structures (https://dev.mysql.com/doc/refman/8.4/en/innodb-on-disk-structures.html)
1764472055181.png

"The doublewrite buffer is a storage area where InnoDB writes pages flushed from the buffer pool before writing the pages to their proper positions in the InnoDB data files."
Khi commit transaction, db không commit thẳng xuống đĩa mà vẫn buffer writes. Vì việc commit thẳng xuống đĩa làm tăng số lượng writes -> giảm I/O throughput.
Ví dụ: peak throughput: 1 write ghi được 100MB -> 100MB/write, khi số lượng writes tăng lên, 2 writes để ghi 100MB -> 50MB/write -> chỉ đạt được 1 nửa throughput của peak.
Không ai viết db thì ông lấy đâu ra ứng dụng db mà dùng?
Fragmentation là khi mà dữ liệu của một file bị nằm rải rác trên nhiều blocks. Trước đây bị fragmentation là do file system không quản lý blocks tốt. Nếu như bây giờ ông dùng SSD nhưng vẫn dùng một file system ngày xưa thì vẫn bị fragmentation.

Nếu không muốn đọc mấy cái "tào lao" thì ít nhất cũng phải đọc mấy cái documentation này chứ. Hay là đến lúc làm lại đi hỏi chatgpt? Đến lúc nó chỉ sai thì lại khóc lóc?
 
Sửa lần cuối:
không nên làm nhiều

Ok chấp nhận mình sai, SSD vẫn bị ảnh hưởng bởi fragmentation

 
DB lúc perform writes cũng không write thẳng vào đĩa mà buffer vào memory trước rồi lúc sau mới ghi vào đĩa. Thế nên DB mới có khái niệm Write-Ahead Log (dùng để revert khi có sự cố). Ví dụ của mysql là redo log.
MySQL :: MySQL 8.4 Reference Manual :: 17.6.5 Redo Log (https://dev.mysql.com/doc/refman/8.4/en/innodb-redo-log.html)
Việc hiểu buffer writes là để đọc hiểu db on-disk structures
MySQL :: MySQL 8.4 Reference Manual :: 17.6 InnoDB On-Disk Structures (https://dev.mysql.com/doc/refman/8.4/en/innodb-on-disk-structures.html)
Xem tệp đính kèm 3361427
"The doublewrite buffer is a storage area where InnoDB writes pages flushed from the buffer pool before writing the pages to their proper positions in the InnoDB data files."
Khi commit transaction, db không commit thẳng xuống đĩa mà vẫn buffer writes. Vì việc commit thẳng xuống đĩa làm tăng số lượng writes -> giảm I/O throughput.
Ví dụ: peak throughput: 1 write ghi được 100MB -> 100MB/write, khi số lượng writes tăng lên, 2 writes để ghi 100MB -> 50MB/write -> chỉ đạt được 1 nửa throughput của peak.
Không ai viết db thì ông lấy đâu ra ứng dụng db mà dùng?
Fragmentation là khi mà dữ liệu của một file bị nằm rải rác trên nhiều blocks. Trước đây bị fragmentation là do file system không quản lý blocks tốt. Nếu như bây giờ ông dùng SSD nhưng vẫn dùng một file system ngày xưa thì vẫn bị fragmentation.

Nếu không muốn đọc mấy cái "tào lao" thì ít nhất cũng phải đọc mấy cái documentation này chứ. Hay là đến lúc làm lại đi hỏi chatgpt? Đến lúc nó chỉ sai thì lại khóc lóc?

Một đóng góp nho nhỏ của mình về comment của bác

DB lúc perform writes cũng không write thẳng vào đĩa mà buffer vào memory trước rồi lúc sau mới ghi vào đĩa. Thế nên DB mới có khái niệm Write-Ahead Log (dùng để revert khi có sự cố)

Không rõ là bác đang gom 2 cái là 1 hay là tách biệt nhưng đúng là khi write xuống disk, DB có buffer vào memory, cụ thể là Doublewrite Buffer, nhưng nó không phải là WAL -> WAL được ghi từ lúc commit. DoublewriteBuffer mục đích chính là tránh torn page, reduce IO có lẽ là benefit "đi kèm".
 
Sửa lần cuối:
Một đóng góp nho nhỏ của mình về comment của bác


Không rõ là bác đang gom 2 cái là 1 hay là tách biệt nhưng đúng là khi write xuống disk, DB có buffer vào memory, cụ thể là Doublewrite Buffer, nhưng nó không phải là WAL -> WAL được ghi từ lúc commit. DoublewriteBuffer mục đích chính là tránh torn page, reduce IO có lẽ là benefit "đi kèm".
Bạn nói đúng. Nhưng chính vì buffer writes nên phải có một cái là WAL. Để nếu chẳng may mà bị crash mà dữ liệu từ buffer chưa được ghi vào đĩa, thì lúc khởi động lại, db sẽ nhìn vào WAL để mà recover.
Đoạn recover sẽ chỉ là những đoạn chưa được ghi vào đĩa. Nếu không thì chẳng có cách nào để mà recover cả. Còn không thì recover trong trường hợp này có ý nghĩa gì? Recover lại data đã có sẵn trong đĩa?

Có lẽ lần sau mình sẽ cố gắng ghi rõ ràng hơn. Mình không có ý định dạy dỗ hay chỉ bảo ai cả, đây chỉ là những kiến thức mà mình học hỏi được và mong muốn được share nó, như là một cách học vậy.
 
Sửa lần cuối:
nếu các pạng đọc textbook dạy DBMS thì sẽ thấy là:

  • WAL là một cái log ghi chú thay đổi data, nó là một cái file trong disk
  • DB không ghi thẳng vào trong WAL file mà sẽ đi thông qua một cái in-memory cache của file đó, cụ thể cache này lưu một tập hợp các page của file WAL
  • cái cache đó người ta gọi là WAL buffer, có thể nghĩ nó là một dạng write buffer
  • nội dung của bảng cũng là file trong disk
  • khi viết vào bảng thì cũng có cơ chế cache tương tự, viết vào cache rồi đi flush
  • cái cache này được gọi là buffer pool, nội dung chứa là page của mấy cái file của bảng, và pạng cũng có thể nghĩ nó là một dạng write buffer
 
Ok chấp nhận mình sai, SSD vẫn bị ảnh hưởng bởi fragmentation

👌
 
Bạn nói đúng. Nhưng chính vì buffer writes nên phải có một cái là WAL. Để nếu chẳng may mà bị crash mà dữ liệu từ buffer chưa được ghi vào đĩa, thì lúc khởi động lại, db sẽ nhìn vào WAL để mà revert.
Đoạn revert sẽ chỉ là những đoạn chưa được ghi vào đĩa. Nếu không thì chẳng có cách nào để mà revert cả. Còn không thì revert trong trường hợp này có ý nghĩa gì? Revert lại data đã có sẵn trong đĩa?

Nhưng chính vì buffer writes nên phải có một cái là WAL

Ý bác là doublewrite buffer? Nếu vậy thì mình nghĩ cái này không đúng. WAL là tận dụng tốc độ sequential write để tăng tốc độ write ( commit) của DB. Tuy vậy không phải vì doublewrite buffer nên phải có WAL, vì WAL xảy ra trước.
Doublewrite buffer xảy ra sau này, khi cần flush dirty innodb pages xuống disk, ở đây dirty pages được gom lại vào một buffer -> ghi xuống disk sequentially block -> sau đó mới write tiếp đến đúng vị trí page trên disk. Doublewrite buffer lúc này dùng để recovery torn page, những chỗ "sau đó mới write tiếp đến đúng vị trí page trên disk" mà lỗi.
 

Thống kê chủ đề

Ngày tạo
Kaiser2013,
Người trả lời cuối
JyRAICK,
Trả lời
352
Lượt xem
41.099
Quay lại
Lên đầu trang