
vunhatnhat
Member
Tôi nói bác trình bày bằng lời nói, đi phỏng vấn ko lẽ bác kêu cho em mượn máy tính, bác search xong rồi quăng cho người pv cái link à

Tôi nói bác trình bày bằng lời nói, đi phỏng vấn ko lẽ bác kêu cho em mượn máy tính, bác search xong rồi quăng cho người pv cái link à

Tính giải thích cho thằng ngu như m hiểu thế nào là auto scale thế nào là zero downtime nhưng nghĩ lại phí quá, t đem giải thích cho bạn bè có ý cầu thị thì hay hơn. M cứ việc đem câu trả lời đó mà đi interview để thiên hạ họ cười cho, chào thân áivãi thanh niên. Dịch google zero downtime = k bao giờ chết. Để không bao giờ service chết thì phải tự động scale lên. giống như 1 thằng bê hòn đá 50kg thì nó chết, nhưng scale 5 thằng bê thì k chết.


Lần đầu nghe cái này. Thanks thím để tìm hiểu thửĐúng rồi. Giải pháp process controller được sử dụng khá nhiều trong các product lớn. Vì nó có thể mở rộng mà không ảnh hưởng tới các service đang chạy. Thím có thể tham khảo mô hình của tiki được chia sẻ trên youtube

eh, ông đừng giải thích cho thằng ngu chủ thớt làm gì, nó đang khích ông để trau dồi kiến thức thôi, để nó hài lòng với cái ngu của nó đizero downtime khi deploy version mới. tôi k nói hệ thống chịu tải.
câu này anh vẫn chưa trả lời được đâu

ông này không biết message queue sinh ra làm gì à ? Sao ông k đẩy message vào queue, gọi RestfuL API thì nó chết mie nó rồi

Rìu lí , mới nghe lần đầu nói auto scale là ko downtime, hay tui chưa phai sé ni oauto scale là zero downtime, hệ thống k bao giờ sập. Tôi làm mãi tôi biết.
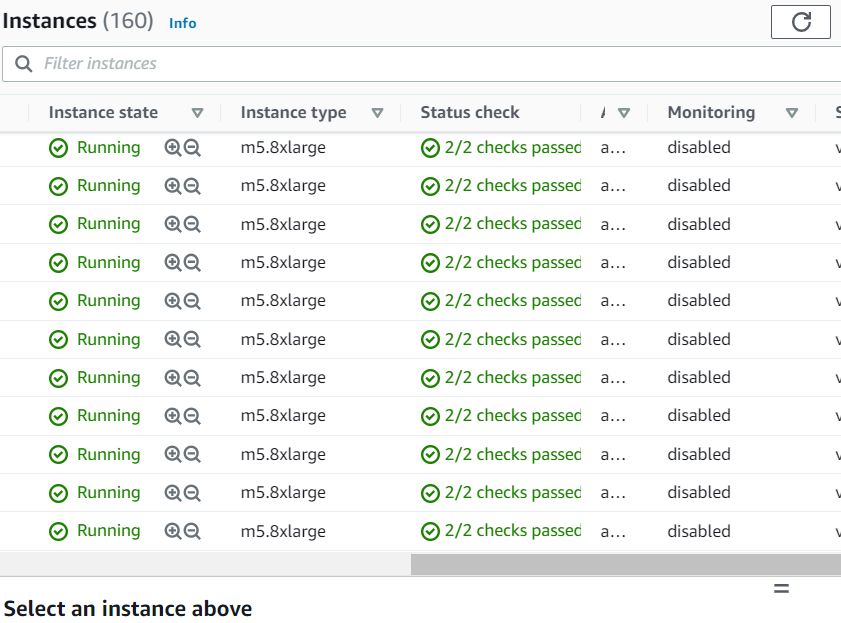
Đù, bác làm hệ thống nào mà tận 160 instance kinh khủng vậy @@Rìu lí , mới nghe lần đầu nói auto scale là ko downtime, hay tui chưa phai sé ni o

160 instance loại m5 x8, chưa kễ cloudfront, global accelator, lb. Mà đang mùa đứt cáp, ở VN chưa có node bên VNPT lên có edge node , global anycast gì con dân VN cũng khóc hếtĐù, bác làm hệ thống nào mà tận 160 instance kinh khủng vậy @@
 . Dự án thành công, tiền hạ tầng ít thì dĩ nhiên duoc đánh giá cao hơn là tốn tiền hạ tầng nhiều.
Chắc bác devops chính hiệu quá, đó giờ t chỉ manage loại t2 micro còn trầy trật160 instance loại m5 x8, chưa kễ cloudfront, global accelator, lb. Mà đang mùa đứt cáp, ở VN chưa có node bên VNPT lên có edge node , global anycast gì con dân VN cũng khóc hết
 . T làm BE nhảy sang support nên k dám đụng chạm nhiều :v
Không mình là SE thuần, trước giờ mình chưa bao giờ làm devops. Thật luôn là làm tới tầm này nhưng chưa bao giờ mình xài ansible, teraform hay mấy con hàng devops hay xài. Ngày xưa thời mình làm system mấy cái tool đó làm gì có, toàn tự viết để xài, đến bây giờ ví dụ có aws thì mình tự viết tool xài với aws-cli chứ cũng ko động tới mấy món kia. Ngoài xài aws thì mình cũng chuyên về networking, có thể bao xô từ router tới switch, firewall, lập trình cũng chơi luôn. Trước khi xài aws mấy hệ thống kiểu aws toàn xài hàng tự build, nên kiến thức hệ thống mình rất cứngChắc bác devops chính hiệu quá, đó giờ t chỉ manage loại t2 micro còn trầy trật

biết nhưng chưa chắc hết đâuVừa hỏi 1 ông bạn IT về vấn đề này. Dăm ba cái lý thuyết thì đi cày cho outsource khoảng 3-4 dự án là biết hết. Nhưng khi interview, nhà tuyển dụng luôn dò hỏi 1 solution nào đó mà NTD đã làm thành công, và yêu cầu ứng viên nêu ra solution đó. Chém ngu nó reject.
1 rou nữa là về English. Pass được rou này kể như cũng đáng cơm gạo


Thế anh dùng message queue, khi deploy code mới lên mà vẫn còn message trong queue chưa xử lí xong thì phải làm thế nào.
Giả sử logic của code cũ và code mới là khác nhau và muốn message cũ giữ logic của code cũ.
Câu hỏi Cto hỏi tôi lúc pv senior dev. Cto hàng xịn ở Eu luôn. Nó hỏi tôi đúng 1 câu thôi
Sent from Samsung SM-G996B using vozFApp

thì mày cứ đi phỏng vấn rồi ném offer lên đây.
Em xây dựng hộ anh 1 hệ thống CI CD zero downtime

Theo mình thì, Tùy vào lúc build dự án, nếu đã dự trù có những case như này thì áp dụng api version, message cũ chạy api cũ, message mới chạy api mới chung trên 1 hệ thống
nếu k chia version được vì 1 số lý do nào đó ví dụ như logic cũ và mới bị conflict về mặt data thì mình nghĩ chỉ có cách chờ message cũ xon hết, và chấp nhận down time để k nhận thêm message mới rồi deploy code mới
Hóng bác chia sẽ thêm
Sent from Samsung SM-G973F using vozFApp
 cái gì cũng phải trade off, hoặc mất tiền để chuyển hướng request qua service mới, queue mới, worker mới. Vẫn để hệ thống cũ chạy song song rồi shutdown dần dần

Mời bác giải thích hộ cái, xgboost vs lightgbm thì không nói làm gì một cái phát triển cây theo chiều dọc, một cái phát triển cây theo chiều ngang.XGboost khác gì với LightGBM
Với Catboost cùng 1 bộ số hyperparams thì chạy với 2 mode CPU và GPU có cho kết quả giống nhau không? Giải thích vì sao?
Chém đi bạn hiền

F12 =]]Rìu lí , mới nghe lần đầu nói auto scale là ko downtime, hay tui chưa phai sé ni o
Còn lúc làm việc ra sao thì chưa cần tính đến.


